NurViewer · 表格识别
表格识别与 Excel 导出
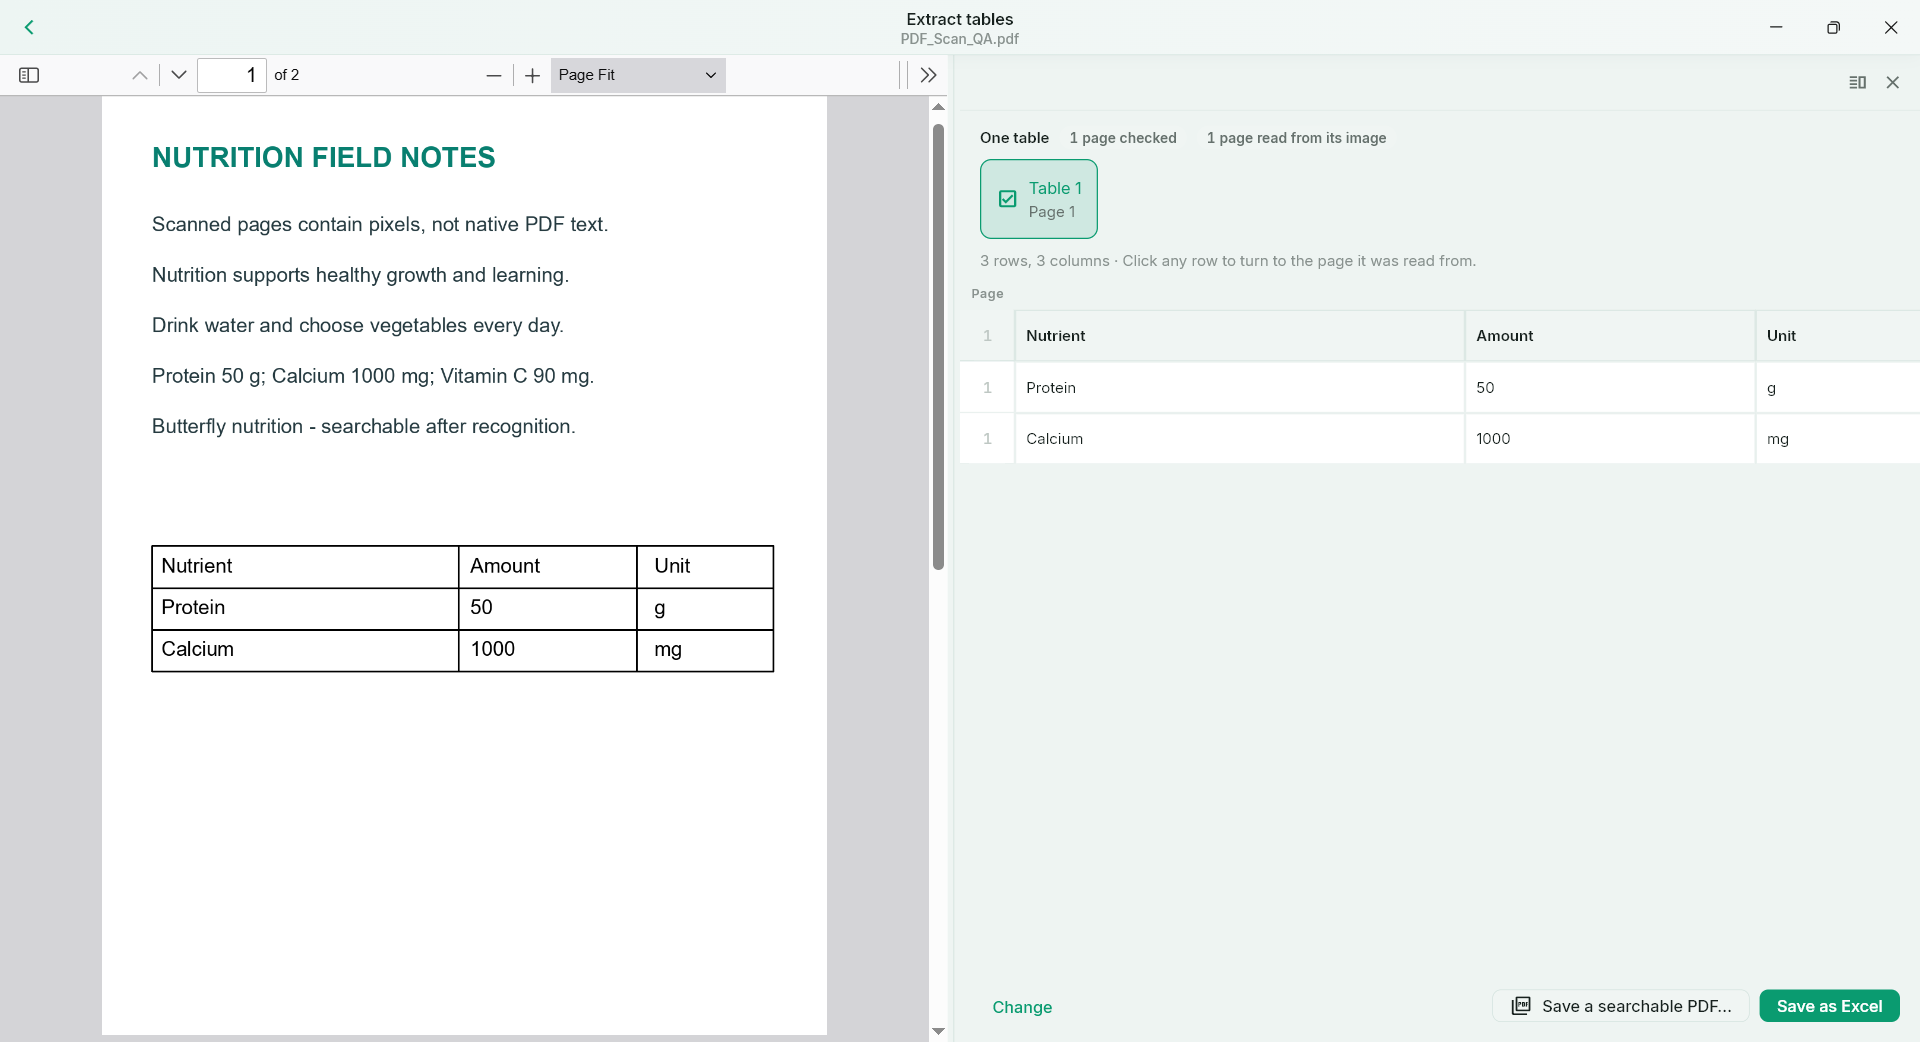
表格截图很好发送,却没法直接计算。普通文字复制又容易丢列、丢空白格,最后仍得逐格重建,真正的数据分析还没开始。
把功能用起来
从需要的内容开始,不必先处理一切。
先用有代表性的内容核对结果,再决定是否扩大处理范围。
- 选择来源页面或表格区域。
- 检查行列边界、合并区域及单元格文字。
- 导出 XLSX,分析前复核关键数字。
版本与适用范围
知道边界,才能放心用。
小数字或特殊版式可能识别错误;不会从图片恢复原 Excel 公式。Free 每天 2 源页、带水印;Standard 20、Pro 120。
Free 没有试用期限:常见格式阅读、普通 PDF 批注及支持的普通文档/图片转 PDF 可长期免费使用。识别、专业格式和高级工具各有自己的额度或版本限制。
查看完整 Free/Standard/Pro 对比 →图示可能保留历史布局;示例图书、词典和媒体不随软件附送。
一个常见疑问
这里为什么不能只用普通文字 OCR?
数字的含义依赖行、列及表头;结构化导出保留支持的关系,才便于继续编辑。